21 septembre 2026
DotJS 2026 : IA dans le navigateur, sécurité et performance web au menu

8 minutes de lecture
DotJS 2026
De retour aux Folies Bergère pour l'édition 2026 de dotJS, l'équipe de Premier Octet a passé la journée à enchaîner les talks (et les lightning talks) de cette conférence JavaScript toujours aussi intéressante. Voici notre résumé des six premiers talks de la journée : un joli mélange d'API navigateur méconnues, d'IA qui tourne enfin en local, et de coulisses de la supply chain npm.
Au programme
The (Abundant) State of the Web
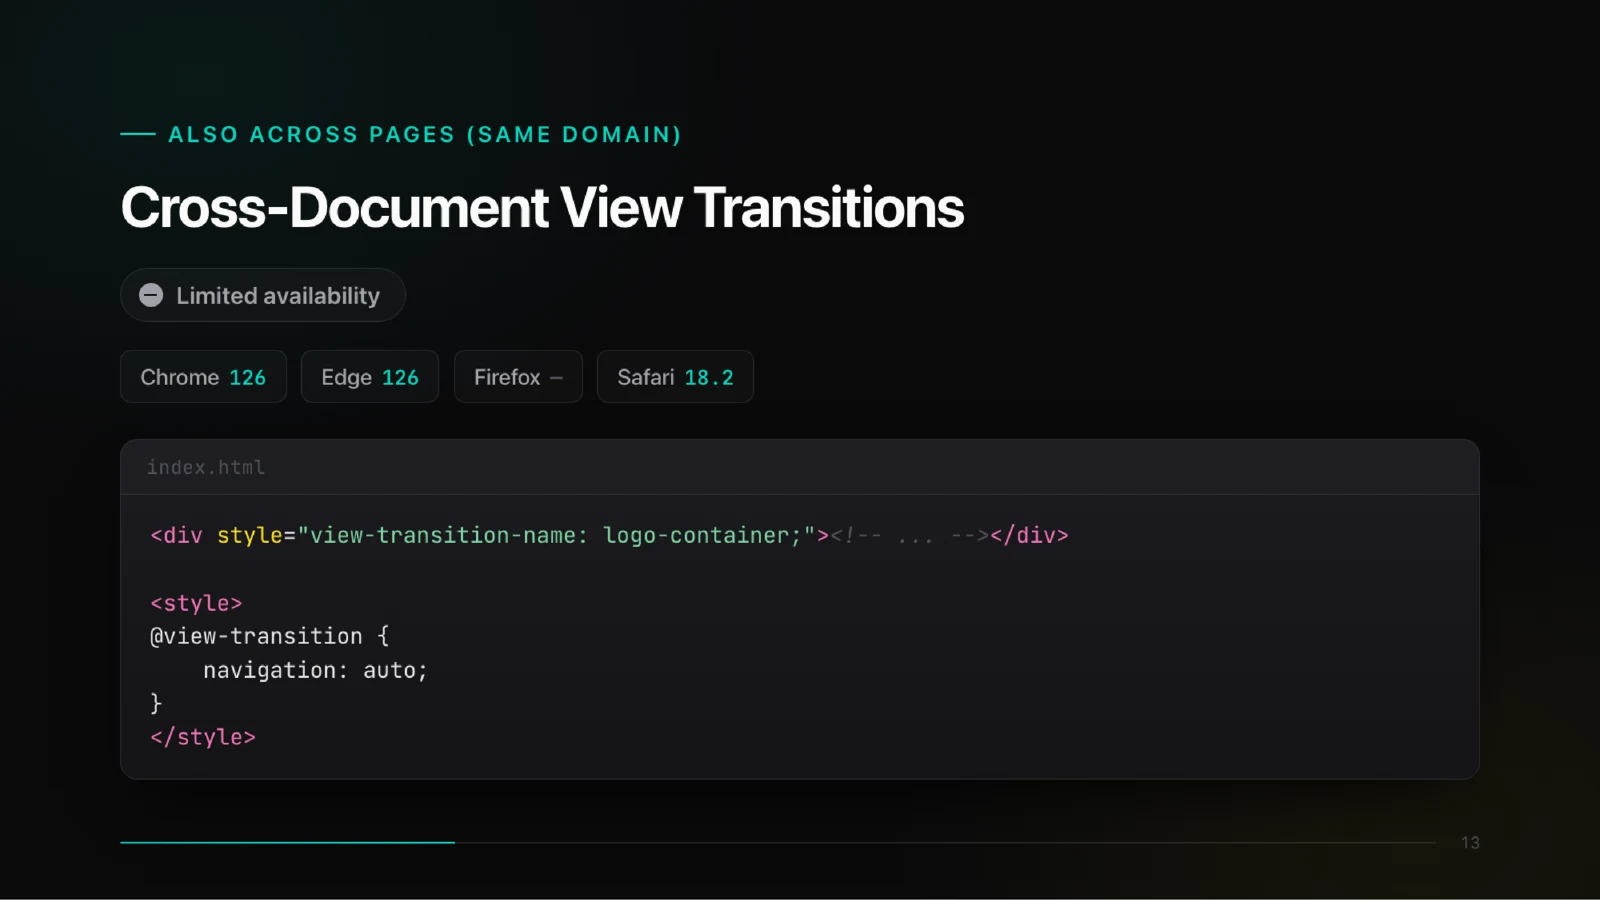
En ouverture, Jad Joubran fait le tour de tout ce que la plateforme web sait déjà faire sans qu'on y pense : <select> personnalisable en CSS, scroll-driven animations, View Transitions API (y compris entre deux pages), et Document Picture-in-Picture pour faire flotter n'importe quel contenu HTML.
Il termine sur les speculation rules / prerendering pour précharger la page suivante avant le clic, et une pointe de transformers.js en clôture pour rappeler que l'IA a, elle aussi, sa place dans ce web "abondant".
💡 Les points clés du talk
- 🎛️ Le
<select>personnalisable et les animations liées au scroll arrivent nativement en CSS - 🔄 La View Transitions API anime les changements d'état, même entre deux documents
- 🪟 La Document Picture-in-Picture API fait flotter n'importe quel contenu HTML au-dessus des fenêtres
- ⚡ Le prerendering/speculation rules permet de précharger la page suivante avant le clic
- 🤖 Même les modèles IA légers (transformers.js) trouvent désormais leur place dans le navigateur
Boring but Effective: WebAI That Ships
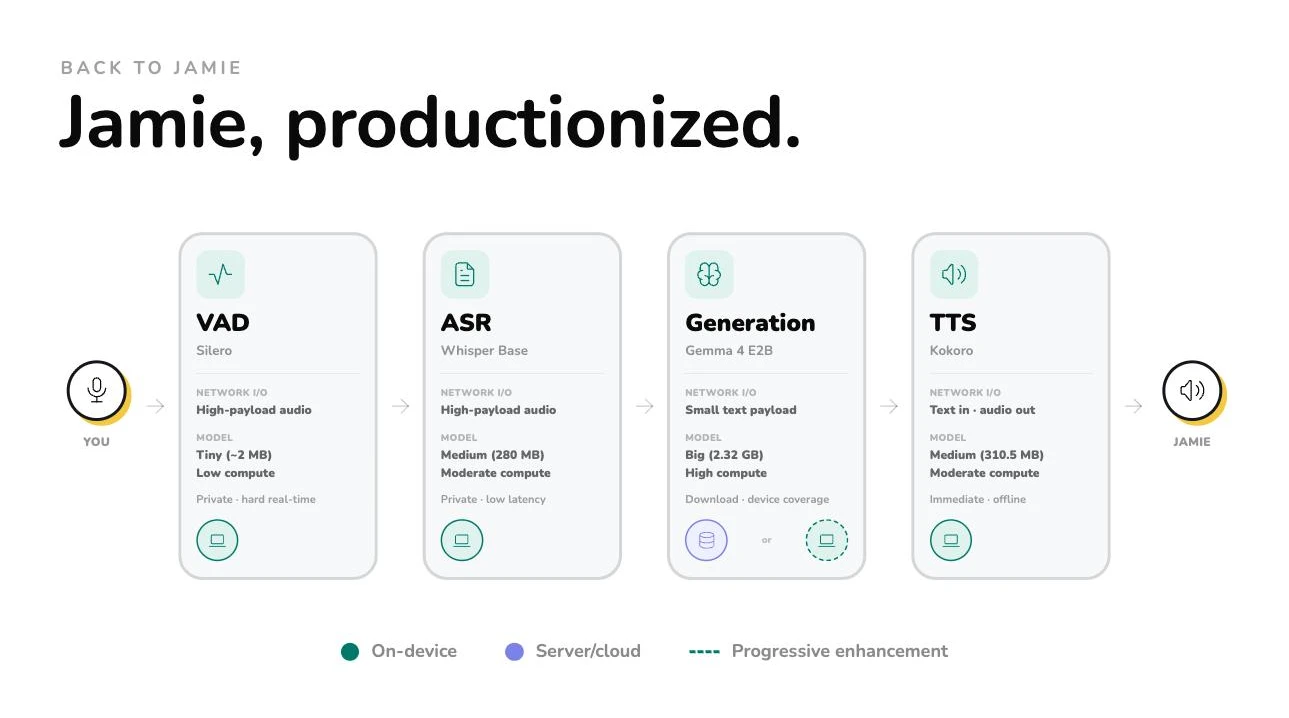
Nico Martin (Hugging Face, WebML) démarre par "Jamie", un assistant vocal de cuisine 100 % local, sans aucun appel serveur, y compris en mode avion. Techniquement, il s'agit d'un pipeline de petits modèles spécialisés (VAD, Whisper-tiny via transformers.js, un LLM léger, un TTS) accéléré par WebGPU, proche du temps réel sur son MacBook M3. Il enchaîne les démos : sous-titrage live, depth estimation, background removal, recherche sémantique, anonymisation locale de données personnelles avant envoi à un LLM cloud.
Il nuance toutefois : l'ensemble de ces modèles pèse plus de 2 Go à télécharger. Son message : pas question de tout faire tourner en local, mais de garder les petits modèles côté client et de laisser les gros modèles, comme les LLM, côté serveur.
💡 Les points clés du talk
- 🎙️ "Jamie", un assistant vocal complet, tourne entièrement offline dans le navigateur via transformers.js
- 🧩 Pas un seul gros modèle mais un pipeline de petits modèles spécialisés (VAD, Whisper, LLM, TTS)
- ⚡ WebGPU permet une transcription proche du temps réel, même sur du matériel modeste
- 🕵️ Démo d'un modèle local d'anonymisation de données personnelles avant envoi à un LLM cloud
- ⚖️ Plus de 2 Go de modèles à télécharger : l'approche est hybride, petits modèles en local, gros modèles (LLM) côté serveur
What You're Really Trusting When You Run npm install
🎤 Karen Li
Karen Li (équipe npm de GitHub) déroule ce qui se passe vraiment derrière npm install : arbre de dépendances figé par le lockfile, ou résolution à la volée bien plus risquée en son absence, avec le cas concret d'un package compromis à l'appui.
Elle présente les parades récentes de npm : "minimum release age" qui met en quarantaine toute version fraîchement publiée, scripts install/postinstall bloqués par défaut depuis npm 12, fin de l'installation depuis des URLs Git arbitraires, et côté publication le passage au "trusted publishing" (tokens de courte durée liés à la CI) et au "staged publishing" (validation d'un mainteneur avant mise en ligne). Sa conclusion : npm install, c'est faire confiance à du code qu'on ne lira jamais, mais ces nouvelles fonctionnalités réduisent nettement cette confiance aveugle.
💡 Les points clés du talk
- 🔒 Sans lockfile,
npm installpeut silencieusement récupérer une version malveillante fraîchement publiée - ⏳ Le "minimum release age" met en quarantaine toute nouvelle version avant qu'elle soit installable en CI
- 🚫 Les scripts
install/postinstallsont désormais bloqués par défaut depuis npm 12 - 🔑 Le "trusted publishing" remplace les tokens npm statiques par des jetons de courte durée liés à la CI
- ✅ Le "staged publishing" impose une validation humaine avant qu'une nouvelle version devienne publique
Web Performance APIs That You (Probably) Never Knew Existed
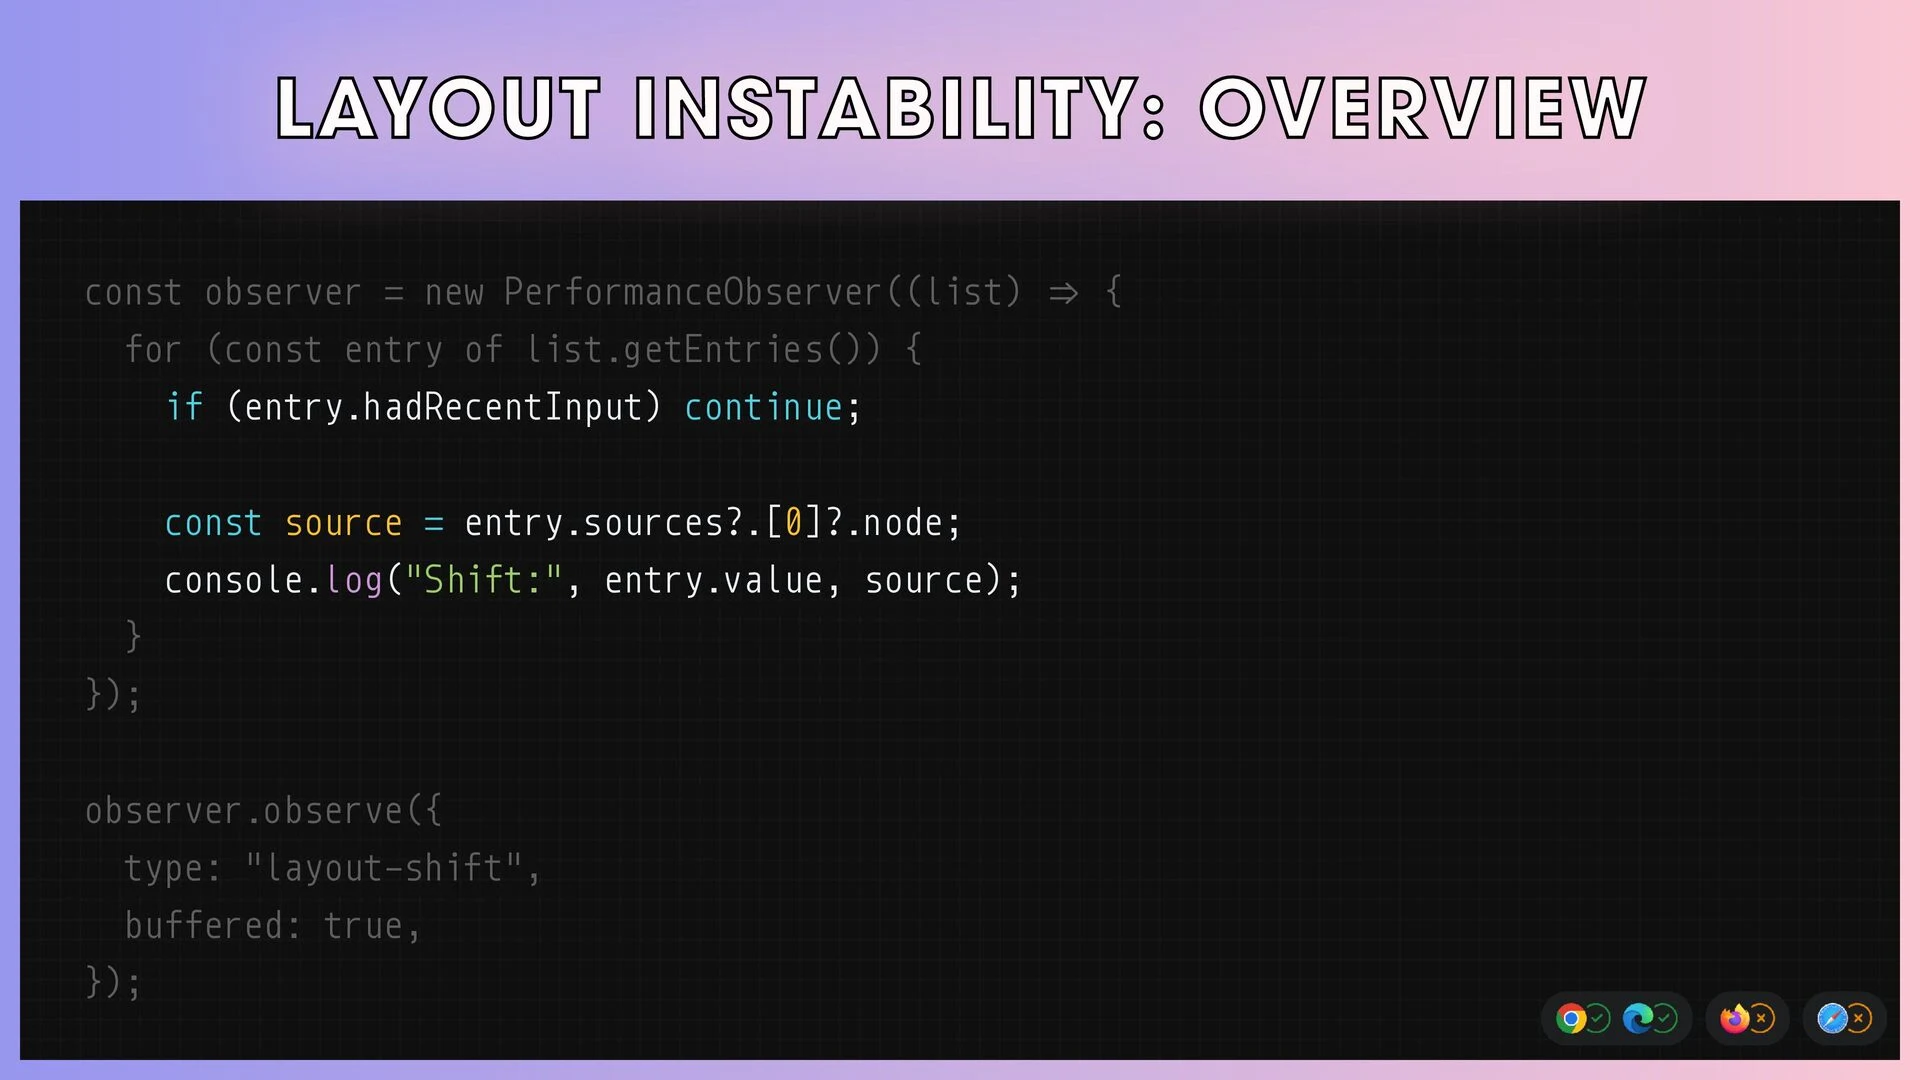
Matheus Albuquerque (Medallia, Google Developer Expert Web Performance) part d'un constat : on connaît les Core Web Vitals, mais rarement les API qui permettent de vraiment comprendre ce qui se passe en prod. Il déroule une liste d'API méconnues : Layout Instability API (quel élément cause un layout shift), Long Animation Frames API (frames de plus de 50ms et script responsable), Self Profiling API (profiler chez l'utilisateur sans devtools), et Memory Measurement API (memory leaks).
Il enchaîne avec la Compute Pressure API (adapter l'app quand le CPU est sous tension), Speculation Rules et Priority Hints (précharger et prioriser les ressources), et la Prioritized Task Scheduling API pour découper les tâches longues, bien plus propre que les anciennes bidouilles à base de générateurs ou de sagas Redux. Il conclut sur la View Transitions API pour des navigations plus fluides.
💡 Les points clés du talk
- 📐 La Layout Instability API identifie précisément quel élément cause un layout shift
- 🐌 La Long Animation Frames API pointe le script responsable d'une frame trop longue
- 🧠 La Memory Measurement API aide à traquer les memory leaks liées aux closures et aux listeners oubliés
- 🔋 La Compute Pressure API permet d'adapter l'application quand le CPU est sous tension
- ⏱️ La Prioritized Task Scheduling API remplace élégamment les vieilles bidouilles pour découper les tâches longues
Unlocking Client-Side AI in Your Web App
Maximiliano Firtman compare l'IA côté client à un train qui prend de la vitesse "en jours, pas en années". Il distingue les briques bas niveau (transformers.js, ONNX Runtime Web, WebLLM, MediaPipe, avec son propre modèle chargé et accéléré par WebGPU/WebNN) des API haut niveau intégrées au navigateur (Translator, Summarizer, Writer/Rewriter, Prompt API), qui s'appuient sur un modèle embarqué comme Gemini Nano sur Chrome, seul navigateur engagé sur ces API pour l'instant.
Démos 100 % offline à l'appui (chatbot, traduction vocale, pose 3D, description d'écran par un modèle Apple), il recommande une approche hybride : choisir, fonctionnalité par fonctionnalité, entre local et cloud plutôt que tout miser sur un seul modèle géant.
💡 Les points clés du talk
- 🚂 L'IA côté client progresse "en jours, pas en années" selon Firtman
- 🧰 Deux approches coexistent : bibliothèques bas niveau (transformers.js, WebLLM…) et API haut niveau intégrées au navigateur
- 🌐 Chrome embarque Gemini Nano pour ses API IA natives ; Firefox et Safari restent en retrait
- ✈️ Toutes les démos tournent 100 % offline, y compris traduction vocale et reconnaissance de pose
- ⚖️ La bonne approche est hybride : choisir, fonctionnalité par fonctionnalité, entre local et cloud
JavaScript tooling has a blind spot: codebase-wide questions
Bart Waardenburg raconte son désenchantement : reboucler les erreurs d'un linter vers un LLM améliore la qualité du code, mais un linter ne voit jamais qu'un seul fichier à la fois. Dead code, duplication, complexité qui grimpe en silence, architecture drift : tout un pan de problèmes reste invisible, aussi bien pour lui que pour ses agents.
Il a donc construit Fallow, un outil d'analyse statique en Rust qui transforme toute une base de code TypeScript/JavaScript en un graphe de dépendances pour repérer le code jamais utilisé, la duplication, les fonctions à forte complexité cyclomatique et fort historique Git (les vraies zones à risque), et les frontières architecturales franchies, le tout complété par une instrumentation runtime pour le dead code en production. Son message : humains comme agents IA ont besoin de cette vue d'ensemble pour bien décider.
💡 Les points clés du talk
- 🕸️ Un linter ne voit qu'un fichier à la fois : le dead code, la duplication et l'architecture drift lui échappent
- 🛠️ Fallow (Rust) construit un graphe de dépendances de toute la base de code pour analyser ces questions à l'échelle du projet
- 🚗 La complexité cyclomatique croisée avec l'historique Git révèle les vraies zones à risque
- 🧪 Croiser complexité et couverture de tests permet de prioriser où regarder en premier
- 🤖 Ces signaux à l'échelle du projet sont aussi précieux pour les agents IA que pour les développeurs humains
Et le reste de la journée ?
L'après-midi a d'abord enchaîné les lightning talks : Nikolay Rodionov sur Skybridge, son framework pour builder des apps MCP, Gabor Csomak sur les microfrontends comme stratégie organisationnelle plutôt que solution technique, Guillaume Moigneu sur TypeScript comme garde-fou pour le code généré par des agents IA, et Thorsten Seyschab avec un quiz JavaScript façon jeu télévisé.
Puis les formats longs ont repris : Vishnudhasan Govindarajan a rappelé que le score Lighthouse ne reflète pas l'expérience réelle en 3G, Harshil Agrawal a montré comment générer et exécuter en sécurité des composants React produits par un LLM via des isolates V8, Devlin Duldulao a retracé l'histoire mouvementée du Date en JavaScript et l'arrivée de Temporal, et Lea Verou a clôturé la journée en interrogeant l'avenir du développement sans bundler.
En bref
Une tendance forte se dégage : l'IA qui tourne vraiment dans le navigateur est passée du gadget de démo à un sujet d'ingénierie sérieux (Nico Martin, Maximiliano Firtman). En toile de fond, deux rappels sur les fondamentaux, sécurité npm (Karen Li) et performance web (Matheus Albuquerque), et une question posée par Bart Waardenburg qui va sans doute devenir centrale : qui garde la vue d'ensemble sur la base de code, à mesure que les agents IA en écrivent une part croissante ?