30 septembre 2026
Dot AI 2026 : Reprendre le contrôle sur nos modèles et nos agents


11 minutes de lecture
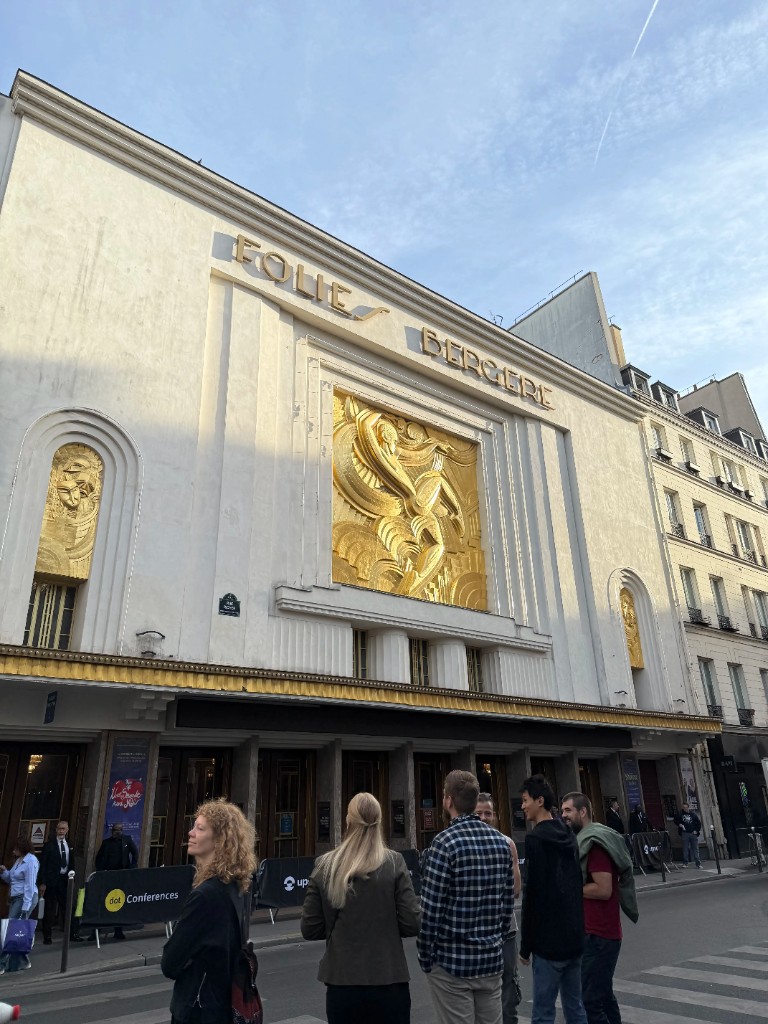
Chez Premier Octet, l'intelligence artificielle s'est imposée au cœur de notre quotidien, que ce soit dans les applications que nous concevons pour nos clients ou au sein de nos propres workflows de développement. La conférence Dot AI, organisée le 17 septembre à Paris, tombait donc à pic pour prendre apprendre, échanger et partager nos expériences avec l'écosystème.
Le constat de cette édition est sans appel : l'industrie a définitivement tourné la page du simple chatbot et du prompt engineering artisanal. L'heure est désormais à l'ingénierie IA. Souveraineté de l'infrastructure, agents autonomes intégrés et protocoles standardisés ne sont plus de simples concepts émergents, mais s'imposent aujourd'hui comme les nouveaux piliers de nos architectures.
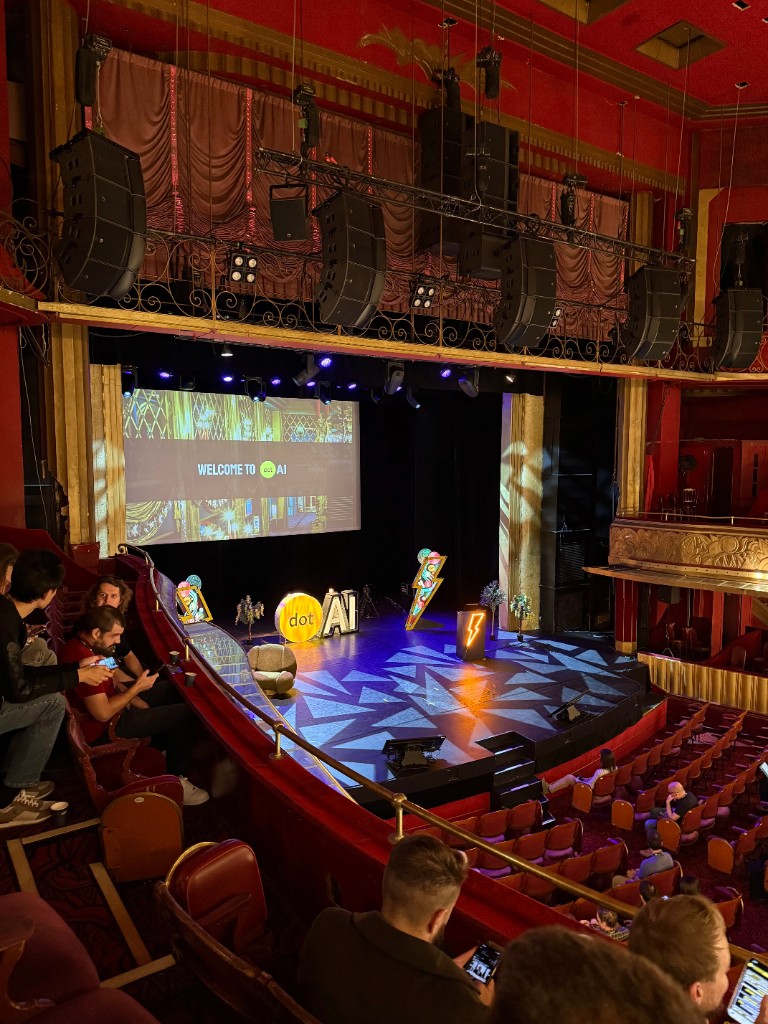
Retour sur six interventions qui ont particulièrement retenu notre attention.
1. Déploiement, Open Source et Inférence Locale : Reprendre le contrôle de l'IA
Si les API propriétaires ont longtemps été le passage obligé, l'essor des modèles open-weights, les avancées en compression et la maturité des moteurs d'exécution permettent aujourd'hui de remettre en question ce modèle du « tout-API ».
Joffrey Thomas & Henry Lagarde – Own your agent
Joffrey Thomas et Henry Lagarde (Mistral AI) rappelle qu'en production, dépendre à 100 % d'API propriétaires fait peser un triple risque sur les projets.
Joffrey Thomas et Henry Lagarde (Mistral AI) ont ouvert le bal avec un rappel utile, en production, dépendre à 100 % d'API propriétaires expose un projet à trois risques.
Le premier est sécuritaire. Envoyer en continu des données sensibles sur des serveurs tiers compromet la confidentialité et la conformité des applications.
Le deuxième concerne la stabilité. Les mises à jour invisibles ou les dépréciations soudaines chez les fournisseurs peuvent casser un agent du jour au lendemain, tout en enfermant l'architecture chez un seul acteur (vendor lock-in).
Enfin, le risque est financier. Les agents exécutant leurs tâches via des boucles autonomes, ils réinjectent l'historique du contexte à chaque itération. Cette accumulation de tokens se transforme en une véritable « taxe invisible » qui rend les coûts rapidement incontrôlables.
La bonne nouvelle, c'est que l'écart de performance entre les modèles fermés et l'Open Source s'est considérablement réduit, passant d'un décalage historique d'un an à environ trois mois seulement. Les deux experts soulignent d'ailleurs qu'à partir d'un volume de 100 millions de tokens par jour, investir dans son propre matériel (comme des GPU dédiés) devient nettement plus rentable que de cumuler les frais d'API.
Leur proposition pour reprendre la main est de mettre en place une « stack souveraine », capable de tourner dans un environnement totalement isolé (air-gapped). Des modèles récupérés sur Hugging Face, quantifiés puis fine-tunés. Un moteur d'exécution optimisé, vLLM en production ou llama.cpp pour prototyper en local. LangChain pour structurer la logique de l'agent et ses appels d'outils. Et Langfuse pour le tracing et la mesure des performances, branché sur les outils d'observabilité habituels comme Datadog ou Grafana.
Xuan-Son Nguyen – llama.cpp: faster and easier for everyone!
Justement, pour faire tourner ces modèles open-source sur son propre matériel sans sacrifier les performances, llama.cpp s'est imposé comme l'outil de référence. Xuan-Son Nguyen a retracé l'évolution de ce projet, ce qui n'était au départ qu'une simple expérimentation codée dans un fichier unique pour faire tourner un modèle sur un ordinateur portable, est aujourd'hui devenu une véritable plateforme d'exécution ultra-optimisée.
Au cœur des récents gains de performance de l'outil se trouve le « speculative decoding ». Normalement, un modèle génère ses tokens un par un, et chaque étape est freinée par les accès mémoire. Le décodage spéculatif contourne ce goulot d'étranglement en générant très rapidement une série de tokens « brouillons » souvent via de petits modèles secondaires rapides ou des motifs récurrents. Ces séquences sont ensuite soumises au modèle principal, plus lourd, qui les valide d'un seul coup. Cette approche produit une inférence jusqu'à 2,12 fois plus rapide sur les benchmarks présentés, pour un surcoût marginal et sans dégradation de la qualité des réponses.
Mais au-delà de la performance brute, c'est l'expérience développeur (DX) qui fait aujourd'hui la force de llama.cpp. Plus besoin d'être un expert en infrastructure matérielle pour en tirer parti. Une commande unique (via llama.app) suffit pour installer et lancer un modèle multimodal en quelques secondes. En ligne de commande ou via un serveur local qui expose une API et une interface web prête à l'emploi, déployer une IA en local n'a jamais été aussi simple.
2. Travailler avec des agents sans perdre la tête
Adopter des agents IA au quotidien ne se résume pas à enchaîner les prompts. C'est revoir sa façon de travailler pour éviter trois pièges : la perte de contrôle, la fatigue mentale et la dégradation silencieuse de la qualité de code.
Guillaume Vernade – Don't Become Your Agent's B****
Guillaume Vernade s'attaque à une promesse séduisante, celle du développeur « chef d'orchestre » qui sirote son café pendant que l'IA code l'application de A à Z. Mais sans cadre, l'expérience oscille entre l'agent qui demande la permission toutes les trente secondes, et celui qui part en roue libre.
La solution ? Traiter l'agent comme un stagiaire très doué avec beaucoup de potentiel, et garder en tête que le premier jour, il ne connaît ni l'organisation du code, ni les règles de l'équipe. Donc on ne le laisse pas pousser en production dès le lundi matin.
Pirelli, un grand philosophe a dit un jour « Sans maîtrise, la puissance n'est rien ». Dans le cas présent, pour garder ce contrôle la vitesse d'exécution doit primer sur la puissance brute. Guillaume conseille de privilégier des modèles ultra-rapides pour maintenir une boucle de feedback très courte, quitte à réserver les LLM plus lourds et massifs uniquement pour la phase de cadrage initial. Il est également crucial d'analyser les trajectoires d'exécution des agents pour repérer les moments où ils s'entêtent à réinventer la roue, gaspillant au passage du temps et des tokens Pour se faire il est primordiale d'écrire des Skills explicites et de ne pas compter sur la mémoire conversationnelle. Les règles telles que les conventions de PR, ton des messages, règles métier, doivent être documentées et maintenues.
Plus provocateur pour des développeurs chevronnés, l'injonction à réévaluer le sacro-saint principe DRY (Don't Repeat Yourself). Accepter la duplication, un agent gère très bien la répétition, et des fonctionnalités bien silotées rendent la revue humaine plus sûre et limitent la portée des régressions.
Enfin, Guillaume a mis en garde contre le piège fatal du context-switching. Les agents prenant parfois plusieurs dizaines de secondes pour accomplir une action, la tentation est grande de lancer dix tâches en parallèle sur dix tickets différents. Cette boulimie d'exécution débouche inévitablement sur une charge cognitive ingérable au moment de relire et valider tout le code produit, laissant souvent derrière soi un cimetière de branches abandonnées.
Ian Massingham – How Anthropic Uses Claude
En tant que responsable de l'IA appliquée pour les startups chez Anthropic, Ian Massingham partage les coulisses de l'utilisation interne de Claude. Aujourd'hui, plus de 80 % du code mergé chez Anthropic est écrit de manière autonome par leur propre modèle, générant un gain de productivité évalué à 8 fois. Ian détaille cinq principes directeurs qui, selon lui, ont directement contribué à cette hausse de productivité :
- Ouvrir l'accès au contexte organisationnel : Connecter l'IA aux outils du quotidien (Slack, Drive, GitHub, Salesforce) afin qu'elle se constitue une véritable mémoire collective au fil du temps et gagne structurellement en pertinence.
- Démocratiser les outils de dev : Déployer des solutions comme Claude Code ou Cowork bien au-delà des seules équipes techniques. Les rendre accessibles aux départements marketing ou sales permet de démultiplier les cas d'usage et d'augmenter la productivité globale de l'entreprise.
- Adapter les interfaces aux usages : S'appuyer sur des intégrations ciblées comme Claude Tag dans Slack, qui embarque l'IA directement dans les canaux d'équipe avec des commandes dédiées et des routines adaptées. Le résultat direct : une réduction drastique du temps de traitement des requêtes et un support automatisé en continu.
- Construire pour la prochaine frontière : Adopter une démarche d'amélioration continue en collectant systématiquement chaque échec de l'agent pour le transformer en test de régression et en benchmark (evals). L'objectif est de s'appuyer sur les modèles les plus avancés pour anticiper les briques techniques appelées à devenir rapidement obsolètes.
- Savoir débrancher l'inutile : Accepter d'éliminer les architectures complexes devenues superflues à mesure que les capacités natives des modèles progressent. Anthropic va jusqu'à confier un rôle de « Reaper » au sein des équipes, dont l'unique mission est de faire le ménage et de supprimer le code historique pour forcer la concentration sur les meilleures solutions actuelles.
3. Ouvrir la boîte noire et standardiser le Web pour l'IA
Pour concevoir les systèmes de demain, il devient indispensable de comprendre la mécanique interne des LLM et de leur fournir des interfaces robustes pour interagir avec le monde extérieur.
David Louapre – Mechanistic Interpretability
David Louapre (Hugging Face), plonge l'audience dans le « mechanistic interpretability », une discipline fascinante souvent qualifiée de « neuroscience de l'IA » car elle cherche à percer le secret de la boîte noire des réseaux de neurones.
Dans les anciens modèles de vision, on trouvait des neurones isolés qui détectaient des courbes ou des têtes de chien. Dans les LLM actuels, les concepts ne vivent plus dans un neurone, mais dans des directions d'un espace d'activation de plusieurs milliers de dimensions.
Pour bien comprendre le défi, il faut savoir que contrairement aux anciens modèles de vision où un neurone isolé pouvait correspondre à un trait visuel précis, les Transformers (l'architecture des LLM) fonctionnent différemment. Ils encodent la connaissance en répartissant chaque idée sur des vecteurs mathématiques à très haute dimension (parfois plus de 8 000 dimensions). Concrètement, un concept n'est pas rangé dans une seule case, il est dilué dans tout le réseau, ce qui le rend de prime abord illisible pour un humain.
C'est là qu'interviennent des méthodes non supervisées comme les Sparse Autoencoders. Ces algorithmes agissent comme des traducteurs capables de démêler cette complexité pour extraire des « dictionnaires de concepts », isolant ainsi des dizaines de milliers d'idées précises et indépendantes au sein de la machine.
La grande avancée est qu'une fois le vecteur d'un concept identifié, on peut le manipuler via l'Activation Steering. Au lieu de guider le modèle avec un prompt, on surstimule artificiellement ce vecteur pendant que l'IA génère sa réponse. David Louapre l'a illustré avec le concept de la « Tour Eiffel » : en amplifiant un vecteur, le modèle oriente de lui-même ses réponses pour y glisser une référence au monument, quelle que soit la question initiale. Si une stimulation légère infléchit subtilement le texte, une injection trop forte détruit totalement la cohérence du raisonnement.
Si cette plongée dans les réseaux de neurones ressemble à de la recherche fondamentale, l'enjeu est en réalité extrêmement concret pour les développeurs. L'interprétabilité mécaniste révèle la façon exacte dont les modèles stockent, représentent et manipulent l'information. Dans un contexte de mise en production, cela devient un outil pratique redoutable pour assurer la sécurité, l'alignement et la modification du comportement des grands modèles. Au lieu d'empiler des consignes dans un prompt en espérant que l'IA respecte ses garde-fous, il devient envisageable d'ajuster mathématiquement sa trajectoire à la source pour garantir qu'elle reste toujours fiable et alignée avec les règles métier.
Patrick Brosset – WebMCP: Stop scraping the Web, start calling it
Du côté des interactions avec le monde extérieur, Patrick Brosset met le doigt sur l'une des plus grandes vulnérabilités de l'IA actuelle : la fragilité des agents qui naviguent sur le Web. Aujourd'hui, la majorité de ces systèmes s'appuient sur le scraping HTML, l'arbre d'accessibilité ou l'analyse de captures d'écran pour deviner où cliquer. Cest lent, extrêmement coûteux en tokens, et l'intégration explose à la moindre modification du DOM.
Pour sortir de cette impasse, un groupe de travail du W3C (épaulé par des acteurs comme Microsoft, Google et OpenAI) a développé un nouveau standard : le protocole WebMCP. L'idée est de passer d'une logique d'exploration visuelle à une logique d'API. Concrètement, WebMCP permet aux développeurs web d'exposer nativement des contrats d'outils (Tool Contracts) directement aux agents via le navigateur.
L'implémentation a été pensée pour s'intégrer avec un minimum de friction dans une base de code, selon deux approches. La première est déclarative : il suffit d'ajouter de simples attributs HTML (tool-name, tool-description) sur des formulaires existants pour les rendre compréhensibles par l'IA. La seconde est programmatique, permettant d'enregistrer dynamiquement des outils en JavaScript via document.modelcontext.registerTool().
navigator.modelContext.registerTool({
  name: 'addToCart',
  description: 'Ajoute un produit au panier',
  inputSchema: {
    type: 'object',
    properties: { productId: { type: 'string' } },
  },
  async execute({ productId }) {
    await cart.add(productId)
    return { content: [{ type: 'text', text: 'Produit ajouté' }] }
  },
})
Contrairement au MCP côté serveur, WebMCP vise les scénarios avec un humain dans la boucle et conserve l'état de l'application côté client. Et même si ce standard est très récent et que ses spécifications sont toujours en cours de définition, son impact potentiel est massif. En remplaçant la navigation visuelle hasardeuse par des appels d'outils standardisés, on obtient des exécutions plus rapides et avec une consommation de tokens réduite de moitié. Une évolution indispensable à l'heure où les agents autonomes s'apprêtent à devenir les premiers utilisateurs du Web.
Conclusion
Après l'exploration et les tâtonnements des débuts, l'industrie entre désormais dans une phase d'ingénierie rigoureuse. Choisir le bon outil pour chaque tâche plutôt qu'un LLM universel, réduire sa dépendance aux API propriétaires avec une stack souveraine, encadrer les agents comme on encadre un collaborateur, adopter des standards comme WebMCP, telles sont les clés du succès d'un projet IA.
Rien de magique, donc. Juste de l'ingénierie. Et c'est plutôt une bonne nouvelle : c'est notre métier. Et chez Premier Octet, toutes ces pistes de réflexion nourrissent déjà nos propres chantiers en cours.
Et vous, quelles sont vos prochaines étapes pour intégrer ces usages dans vos applications ? Que vous souhaitiez lancer une première réflexion ou concrétiser une architecture IA sur mesure, contactez-nous pour échanger sur vos problématiques et construire ensemble votre prochain projet.